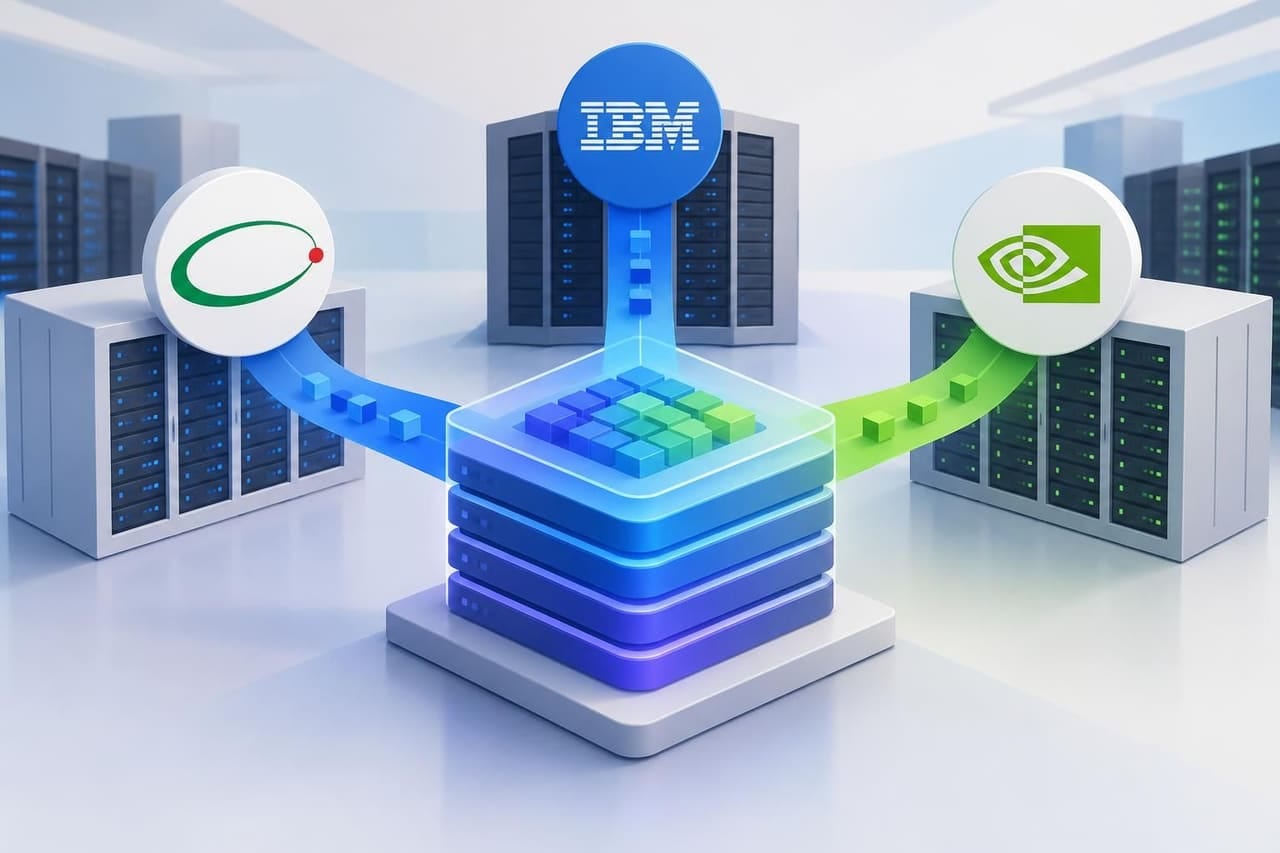
Supermicro anunció una solución de caché KV compartida junto con IBM y NVIDIA que apunta a evitar que la inferencia de IA repita cálculos de contexto ya procesados. La compañía no informó precios ni un calendario de envíos en el anuncio recogido el 6 de noviembre.
El contexto deja de depender solo de la memoria de la GPU
La propuesta busca conservar y reutilizar la caché KV —los datos intermedios que generan los modelos durante una conversación o una petición extensa— mediante almacenamiento compartido. En lugar de mantener ese contexto únicamente dentro de la memoria de una GPU, el sistema plantea ponerlo a disposición de más recursos de cómputo.
Para empresas que operan asistentes, búsqueda semántica o flujos con agentes, la caché KV puede convertirse en un componente costoso: cuanto más largo es el historial que debe conservarse, más memoria se consume. La solución de Supermicro intenta que la inferencia de IA reaproveche ese trabajo cuando las solicitudes vuelven a necesitar el mismo contexto.
Una pieza de infraestructura, no un nuevo modelo
El anuncio no presenta un modelo de lenguaje ni una GPU nueva. Se trata de una capa de infraestructura para servidores de IA, un terreno donde la eficiencia depende cada vez más de mover, guardar y recuperar datos con rapidez, además de sumar aceleradores.
La participación de IBM y NVIDIA sitúa la iniciativa alrededor de infraestructura para centros de datos y cargas de IA empresarial. Sin especificaciones publicadas sobre rendimiento, compatibilidad, precio o disponibilidad, todavía no es posible medir cuánto reduce la latencia o el uso de GPU frente a configuraciones convencionales.
Qué cambia para los equipos que sirven modelos
Si la implementación cumple su objetivo, los operadores podrían reservar más memoria de GPU para atender nuevas solicitudes y reducir cálculos redundantes en aplicaciones con muchas consultas relacionadas. Ese beneficio depende de cómo se integre la caché KV con el almacenamiento, la red y el software que orquesta la inferencia de IA.
Por ahora, el avance debe leerse como un anuncio de plataforma. Supermicro no detalló cuándo podrán comprarla o desplegarla los clientes, por lo que las compañías interesadas tendrán que esperar datos técnicos y comerciales para evaluar su adopción.
La información disponible fue publicada en el resumen de lanzamientos del 6 de noviembre de Shadow Intelligence.